 ETHORITY®
GOOD AI PRISMA · TECHNOLOGIESCHICHT · DATENSÄTZE
12 Trainingsdatensätze. 5 brauchen eine Lizenzprüfung.
Wählen Sie Daten, die Sie nutzen dürfen: 12 Datensatzkarten vergleichen Umfang, Lizenz, Sprachen und Zeitraum, jeweils mit Quelle des Herausgebers und Abrufdatum.
- 12
- Trainingsdatensätze, Fakt für Fakt beschriebenGood AI Prisma Registry, gelesen am 25. Okt. 2026
- 15 Bio.
- englische Tokens in FineWeb, unter ODC-By 1.0Hugging Face FineWeb, 2024 · huggingfacefw-blogpost-fineweb-v1.static.hf.space ↗
- 300 Mrd.+
- Webseiten im Archiv von Common CrawlAWS Open Data, gelesen am 25. Okt. 2026 · aws.amazon.com ↗
- 137
- Sprachen in Mozilla Common Voice 22.0Mozilla, 25. Juni 2025 · discourse.mozilla.org ↗
Der Benchmark-Klassiker ist nur für die Forschung.
Die Zugangsvereinbarung von ImageNet beschränkt die 1,28 Millionen Trainingsbilder auf nicht kommerzielle Forschung und Lehre.
ImageNet, Zugangsvereinbarung, gelesen am 25. Okt. 2026
Qualitätsfilter verwerfen das meiste Web.
Die strengere Schwelle von FineWeb-Edu entfernt 92 % von FineWeb, um Seiten mit Bildungsqualität zu behalten.
Hugging Face FineWeb, 2024
Deduplizierung ist die halbe Geschichte.
Rund 40 % der frei lizenzierten Dateien in The Stack v2 waren vor der Deduplizierung Duplikate.
BigCode, Datensatzkarte The Stack v2, gelesen am 25. Okt. 2026
Webtext
Gecrawlte und gefilterte Web-Korpora. Alle beginnen beim Archiv von Common Crawl; Filter, Sprachen und Lizenzen unterscheiden sich.
Common Crawl
Common Crawl · Datensatz
Offenes Archiv von Web-Crawl-Daten, das jede und jeder abrufen und auswerten kann; verbreitet beim Training von Sprachmodellen.
FineWeb
Hugging Face · Datensatz
Offener Datensatz mit über 18,5 Billionen Tokens bereinigtem, dedupliziertem englischem Webtext aus Common Crawl, für Forschung zum Vortraining von Sprachmodellen.
Bilder, Sprache und Enzyklopädie
Die größte Spanne an Bedingungen: von nur Forschung bis CC0.
LAION-5B
LAION · Datensatz
Offener Datensatz mit 5,85 Milliarden Bild-Text-Paaren für das Training von Bildmodellen.
Datensätze und Datenplattformen sind verschiedene Karten
Eine Datensatzkarte beschreibt ein Korpus: was es enthält, unter welcher Lizenz, in welchen Sprachen und mit welchen Lücken. Datenplattformen und Vektordatenbanken sind Software und behalten deshalb Produktkarten mit Preis, Hosting und Trainingsbedingungen im Themenfeld Data & Analytics. Querverweise gelten in beide Richtungen: Eine Plattformkarte kann die Datensätze nennen, die sie bereitstellt, etwa Common Crawl auf AWS Open Data.
Die Evidenz lesen
Deutschland · DE
28 Anbieter haben den EU-Kodex für KI-Modelle unterzeichnet.
KI-Modelle als Portfolio steuern: wer sie baut, was sie kosten, wie lange sie verfügbar bleiben und welche Regeln gelten.
Version 1.5 · 38 Seiten
Studie lesen →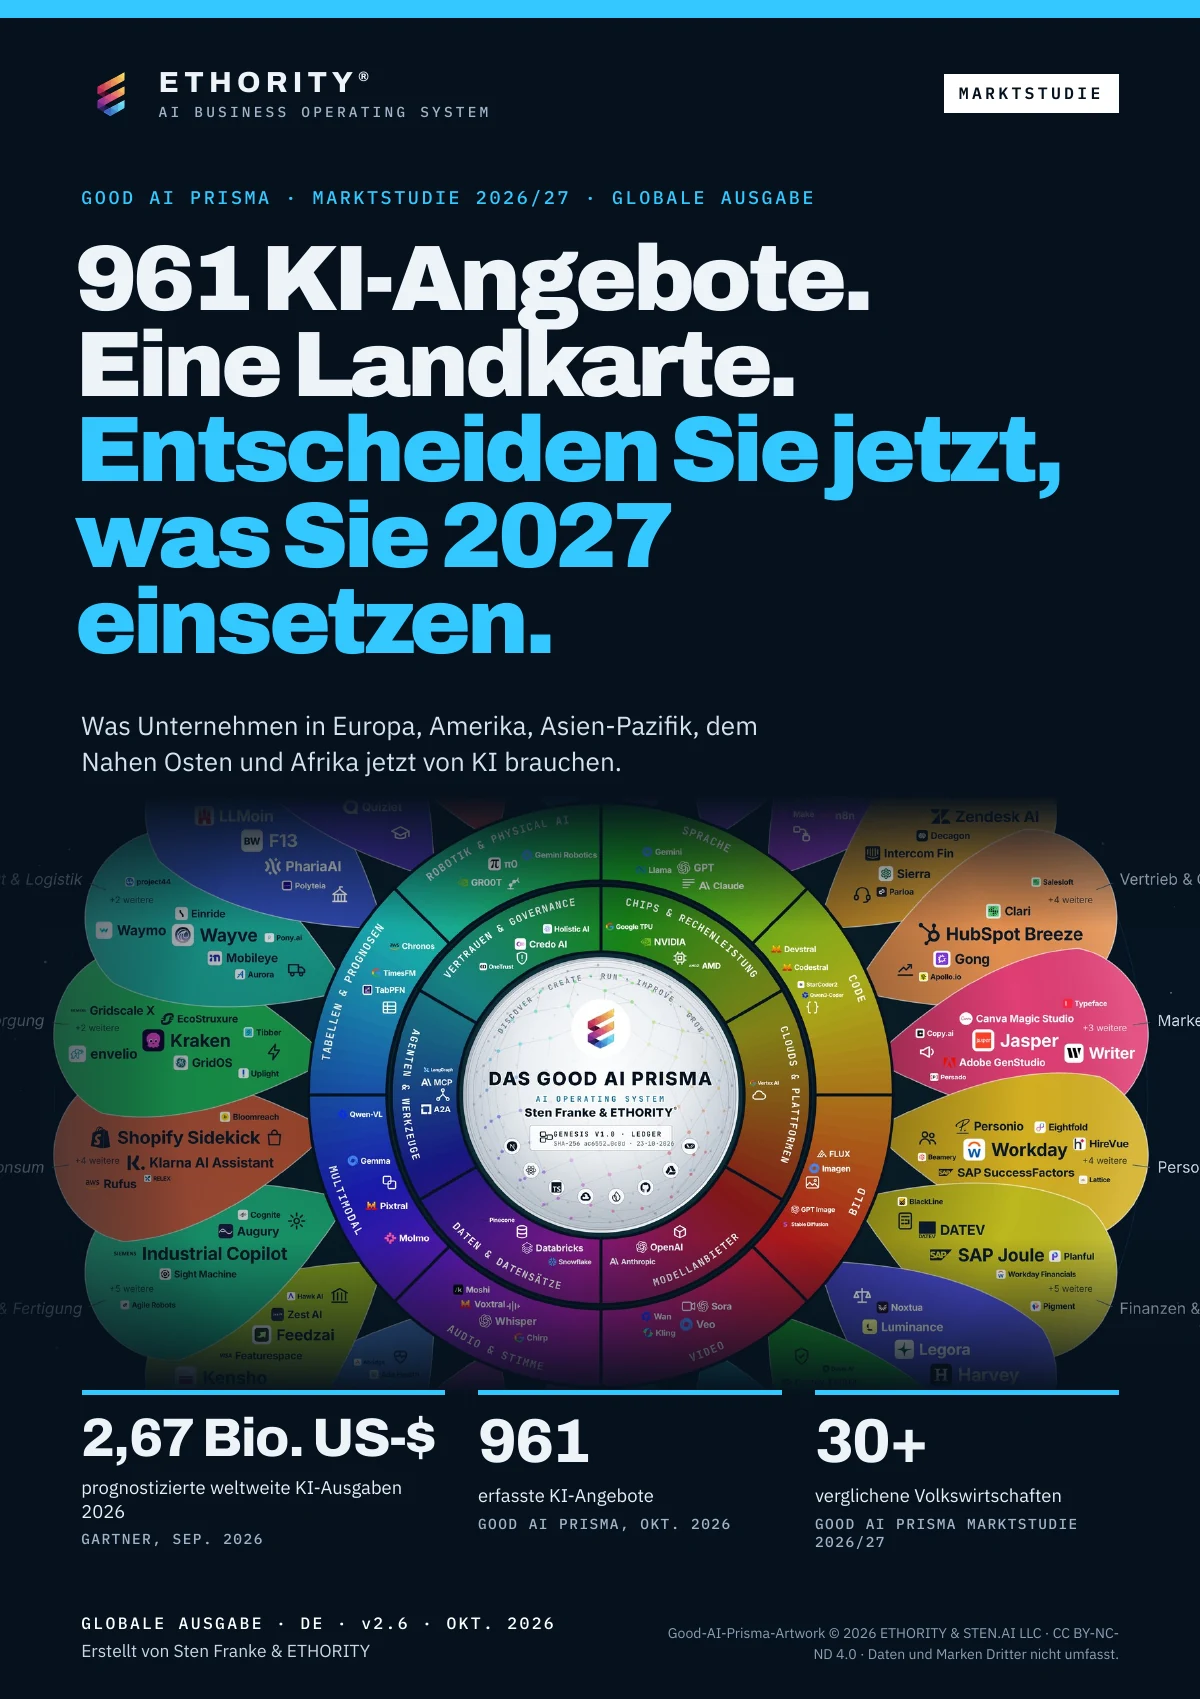
Globale Ausgabe · DE
961 KI-Angebote. Eine Landkarte. Entscheiden Sie jetzt, was Sie 2027 einsetzen.
Das Good AI Prisma hilft Ihnen, sinnvolle KI-Anwendungen zu finden und die Belege zu Ihren Optionen zu vergleichen. Für Unternehmen, die KI schon nutzen, verschiebt sich die Frage von „ob KI“ zu „welche KI, wie sicher und ob sie sich rechnet“. Diese globale Ausgabe umfasst 961 KI-Angebote in 24 Themenfeldern, 8 Datenarten und 6 Technologieschichten – mit Quellen, Datenstand und Grenzen der Aussagekraft, damit Sie Ihre nächste Entscheidung fundiert treffen.
Version 2.6 · 90 Seiten
Studie lesen →Weitere Beiträge
Eine Anbieterzusage ist noch kein Beleg.
Prüfen Sie jede Zusage eines Anbieters an Produkt, Version, Vertrag und Einsatzzweck, bevor Sie sich darauf verlassen.
Analyse zur Karte lesen →
Synthetische Medien brauchen fast überall eine Kennzeichnung.
Was sich bei künstlich erzeugten Gesichtern und Stimmen seit dem Modell VASA-1 geändert hat und welche Kennzeichnungsregeln gelten.
Analyse zur Karte lesen →
Zehn ethische KI-Fragen haben jetzt feste Fristen.
Die zehn ethischen Fragen von 2024 haben jetzt ein Rechtsdatum, eine messbare Kontrolle oder einen Beleg.
Analyse zur Karte lesen →Mit ETHORITY umsetzen
AI Decision Brief
195 € netto · einmalig
Stellt die entscheidenden Fakten zu zwei oder drei Optionen nebeneinander, jeweils mit Quelle und Datum, plus die Fragen an jeden Anbieter.
Umfang und Lieferung anfragen
Leistungsumfang des Pakets ansehen →AI Opportunity Case
Preis nach Umfang
Vergleicht echte Optionen einschließlich Nichtstun, rechnet die Wirtschaftlichkeit samt kritischer Annahmen durch und empfiehlt: starten, ändern, erst testen oder stoppen.
Umfang und Lieferung nach Vereinbarung
Leistungsumfang des Pakets ansehen →Fragen von Einkäufern
Dürfen wir diese Datensätze in einem kommerziellen Produkt nutzen?
Das hängt vom Datensatz und den darunterliegenden Rechten ab. ImageNet ist nur für die Forschung, The Stack v2 folgt der Lizenz jeder Datei, und LAION rät vom Produkteinsatz ab. Fragen Sie Ihre Rechtsberatung, bevor Sie sich darauf stützen.
Klärt eine offene Lizenz alle Rechte?
Nein. ODC-By oder CC BY-SA decken die Zusammenstellung ab; gecrawlte Seiten, Codedateien und verlinkte Bilder behalten die Rechte ihrer Inhaber, und die Nutzungsbedingungen von Common Crawl gelten zusätzlich.
Welche Datensätze decken Deutsch ab?
RedPajama-Data-v2 enthält Deutsch, Common Voice deckt 137 Sprachen ab, Wikipedia hat mehr als 300 Sprachausgaben. FineWeb, FineWeb-Edu und Dolma sind nur englisch.
Was fragen wir einen Modellanbieter zu Trainingsdaten?
Welche Korpora, welche Lizenzen, welche Filter und wie Löschanfragen behandelt werden. Nach der EU-KI-Verordnung müssen Anbieter von Allzweckmodellen eine Zusammenfassung der Trainingsinhalte veröffentlichen.
Wie aktuell sind die Karten?
Jeder Fakt zeigt Quelle und Lesedatum; die aktuellen Karten wurden am 25. Okt. 2026 gelesen. Der Modell-Hub zeigt, welche Modelle worauf trainiert wurden, wo Anbieter es angeben.
ETHORITY · ANALYSE
Welcher Datensatz, für welche Aufgabe, unter welchen Bedingungen
Fünf von 12 verbreiteten Trainingsdatensätzen haben eine Bedingung, die vor dem Produkteinsatz zählt. Was Lizenzen, Sprachen und Filter sagen, und fünf Fragen, bevor Ihr Modell daraus lernt.
Jedes KI-Modell beruht auf Daten, die jemand anderes gesammelt hat. Wer ein Modell feinjustiert, ein eigenes trainiert oder ein Werkzeug kauft, das es getan hat, übernimmt Lizenz, Abdeckung und Lücken des Datensatzes. Das Good AI Prisma beschreibt jetzt 12 der meistgenutzten öffentlichen Trainingsdatensätze, Fakt für Fakt. Fünf davon haben eine Bedingung, die vor dem Produkteinsatz zählt.
Das Web ist die Basisschicht, und es ist eine Stichprobe
Die meisten Textdatensätze beginnen bei Common Crawl, einem gemeinnützigen Archiv mit mehr als 300 Milliarden Webseiten, monatlich kommen 2,3 bis 2,7 Milliarden Seiten hinzu, laut der Darstellung von AWS Open Data. Die eigene FAQ ist genau: eine Stichprobe des Webs, keine vollständige Kopie, gesammelt von einem Crawler, der robots.txt beachtet. Das Urheberrecht an den Seiten bleibt bei den Inhabern.
Kuratierte Korpora filtern diese Basis. FineWeb von Hugging Face verdichtet 96 Crawl-Schnappschüsse zu 15 Billionen englischen Tokens unter ODC-By 1.0. FineWeb-Edu geht weiter: Ein Klassifikator für Bildungsqualität behält nur die bestbewerteten Seiten und entfernt bei der strengeren Schwelle 92 % von FineWeb. RedPajama-Data-v2 wählt den anderen Weg. Es liefert 30 Billionen deduplizierte Tokens in fünf Sprachen, Englisch, Französisch, Spanisch, Deutsch und Italienisch, dazu mehr als 40 Qualitätssignale, und überlässt das Filtern Ihnen.
92 %. Der Anteil von FineWeb, den die strengere Qualitätsschwelle von FineWeb-Edu entfernt. Der größte Teil des Webs ist nicht das, woraus ein Modell lernen soll.
Für Einkäufer heißt das: „mit Webdaten trainiert“ sagt wenig. Fragen Sie nach Crawl, Filter, Sprachfilter und Deduplizierung. FineWeb und Dolma sind nur englisch. Wenn Ihre Nutzer Deutsch schreiben, ist das ein Abdeckungsfakt, kein Detail.
Dolma vom Allen Institute for AI mischt 15 Quellen, von Webseiten und wissenschaftlichen Artikeln bis zu Code, Büchern und Wikipedia, zu rund 2,3 Billionen Tokens unter ODC-BY. C4, das Korpus hinter vielen frühen Modellen, umfasst 305 GB bereinigten englischen Webtext; die mehrsprachige Variante mC4 deckt mehr als 100 Sprachen ab. Beide Lizenzen binden Sie zusätzlich an die Bedingungen ihrer Quellen.
Code und Mathematik haben eigene Regeln
The Stack v2 umfasst 67,5 TB Quellcode in mehr als 600 Programmiersprachen. Jede Datei behält ihre ursprüngliche Lizenz, die Nutzung muss diesen Lizenzen folgen, mit Namensnennung, wo verlangt. Rund 40 % der Dateien unter freizügigen Lizenzen waren vor der Deduplizierung Duplikate, und der Datensatz kann E-Mail-Adressen oder Schlüssel enthalten, die einmal öffentlich auf GitHub standen. Es gibt ein Opt-out-Werkzeug und Löschanfragen. OpenWebMath ergänzt 14,7 Milliarden Tokens mathematischen Webtext mit LaTeX.
Bilder und Sprache: die Bedingungen zweimal lesen
Bei Bilddatensätzen ist die Lücke zwischen Bekanntheit und Erlaubnis am größten. ImageNet, der Benchmark-Klassiker mit 1,28 Millionen Trainingsbildern, steht unter einer Zugangsvereinbarung „nur für nicht kommerzielle Forschung und Lehre“ zur Verfügung. LAION-5B listet 5,85 Milliarden Bild-Text-Links; LAION empfiehlt den Satz nicht für fertige Industrieprodukte und betont, dass die Bilder beim Urheber bleiben. Die Veröffentlichung Re-LAION-5B vom 30. August 2024 entfernte Links, die mit Missbrauchs-Hashlisten übereinstimmten, sowie Links nach Datenschutzanfragen.
Bei Sprache sieht es anders aus. Mozilla Common Voice umfasst in Version 22.0 33.815 Stunden in 137 Sprachen. Mozilla hat die Daten als CC0 veröffentlicht, frei von urheberrechtlichen Beschränkungen; prüfen Sie die Bedingungen der jeweils genutzten Version. Wikipedia-Text steht unter CC BY-SA, das kommerzielle Nutzung mit Namensnennung und Weitergabe unter gleichen Bedingungen erlaubt.
Was die EU-KI-Verordnung ändert
Nach der 2026 geänderten KI-Verordnung müssen Anbieter von KI-Modellen mit allgemeinem Verwendungszweck eine Zusammenfassung der Trainingsinhalte veröffentlichen und eine Urheberrechtsstrategie unterhalten. Für Einkäufer werden Datensatzfragen damit zu Unterlagen, die Sie anfordern können. Fragen Sie ausdrücklich nach dieser Zusammenfassung und nach dem Datum ihrer letzten Aktualisierung. Ein Anbieter, der nicht sagen kann, welche Korpora er unter welchen Bedingungen genutzt hat, hat damit auch geantwortet.
Fünf Fragen vor der Nutzung eines Datensatzes
- Was erlaubt die Lizenz für Ihren Zweck: Forschung, kommerzielles Produkt oder Weitergabe?
- Wessen Rechte liegen darunter? Gecrawlte Seiten, Codedateien und verlinkte Bilder behalten die Rechte ihrer Inhaber.
- Welche Sprachen und welcher Zeitraum sind abgedeckt, und passt das zu Ihren Nutzern?
- Wie wurde gefiltert und dedupliziert, und was wurde dabei entfernt?
- Wie werden personenbezogene Daten und Löschanfragen behandelt, und können Sie das dokumentieren?
Die Datensatzkarten beantworten diese Fragen, wo Herausgeber es tun, jeweils mit Quelle und Lesedatum. Datenplattformen und Vektordatenbanken, also die Software, die Daten speichert und bereitstellt, stehen als Produktkarten im Themenfeld Data & Analytics. Die auf diesen Korpora trainierten Modelle finden Sie im Modell-Hub, und die Technologieanalyse KI-Modelle erklärt, was Sie einen Modellanbieter zu seinen Trainingsdaten fragen sollten.
Quellen und weiterführende Literatur
- Common Crawl FAQ ↗ · read 25 Oct 2026
- AWS Public Sector blog: Common Crawl and AWS Open Data ↗ · read 25 Oct 2026
- FineWeb: decanting the web for the finest text data at scale ↗ · 2024
- RedPajama-Data-v2 ↗ · 30 Oct 2023
- The Stack v2 dataset card ↗ · read 25 Oct 2026
- ImageNet access agreement ↗ · read 25 Oct 2026
- LAION-5B ↗ · 31 Mar 2022
- Re-LAION-5B ↗ · 30 Aug 2024
- Common Voice 22.0 release ↗ · 25 Jun 2025
- Common Voice 18 dataset release (licence) ↗ · Jun 2024
- wikimedia/wikipedia dataset ↗ · Nov 2023
- Regulation (EU) 2026/1744 amending the AI Act ↗ · 2026
VON DEN BELEGEN ZU IHRER ENTSCHEIDUNG
Besprechen Sie Ihre Frage mit Sten Franke.
Bringen Sie Ihre Geschäftsfrage oder die bereits bekannten Zahlen mit. ETHORITY recherchiert im vereinbarten Umfang; gemeinsam mit Sten Franke legen Sie den sinnvollen nächsten Arbeitsschritt fest.