 ETHORITY®
GOOD AI PRISMA · THEMENFELD · SOFTWAREENTWICKLUNG
84 % programmieren mit KI. 46 % misstrauen ihr.
Vergleichen Sie Coding-Werkzeuge nach Abrechnungseinheit, Training und Datenstandort und messen Sie die Durchlaufzeit, bevor Sie einem Tempoversprechen glauben.
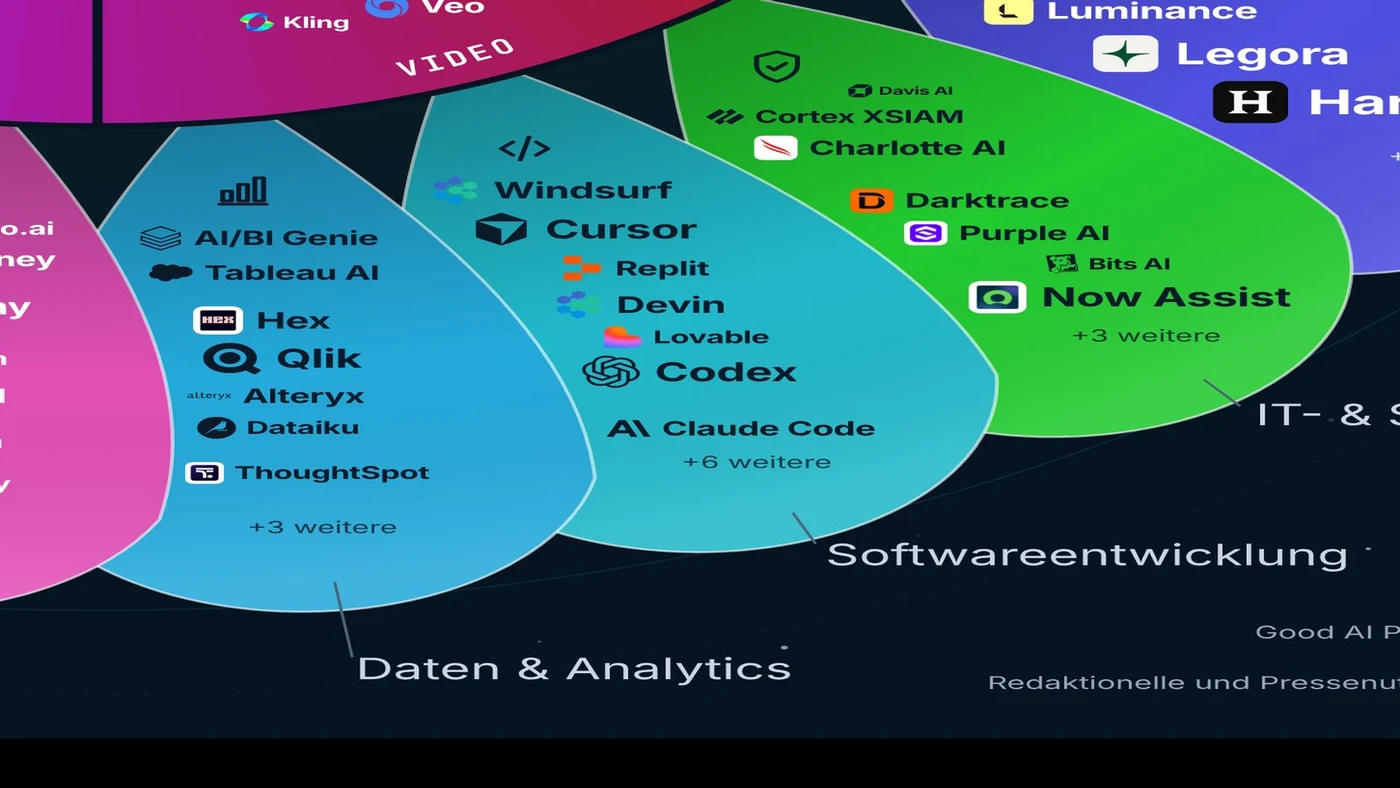
- 24
- KI-Angebote im Themenfeld SoftwareentwicklungGood AI Prisma, Okt. 2026
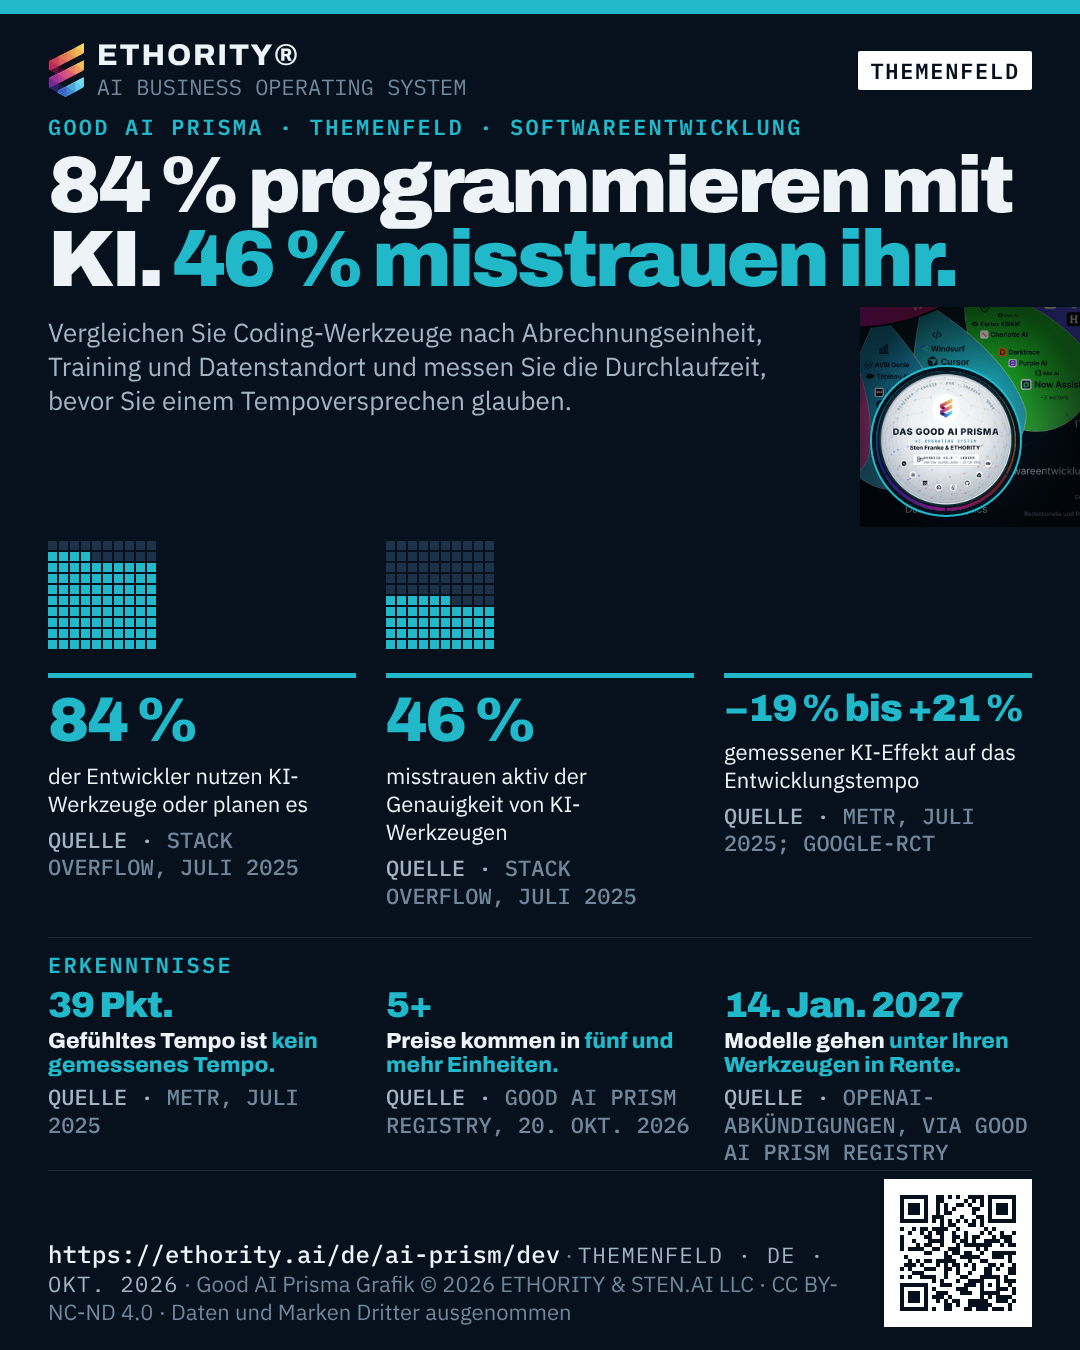
- 84 %
- der Entwickler nutzen KI-Werkzeuge oder planen esStack Overflow, Juli 2025 · survey.stackoverflow.co ↗
- 46 %
- misstrauen aktiv der Genauigkeit von KI-WerkzeugenStack Overflow, Juli 2025 · survey.stackoverflow.co ↗
- −19 % bis +21 %
- gemessener KI-Effekt auf das EntwicklungstempoMETR, Juli 2025; Google-RCT · metr.org ↗
Gefühltes Tempo ist kein gemessenes Tempo.
In der METR-Studie hielten sich Entwickler für 20 % schneller – gemessen waren sie 19 % langsamer.
METR, Juli 2025
Preise kommen in fünf und mehr Einheiten.
Die 12 profilierten Coding-Angebote rechnen nach Tokens, Credits, Plätzen, Tarifstufen oder Rechenleistung ab.
Good AI Prism Registry, 20. Okt. 2026
Modelle gehen unter Ihren Werkzeugen in Rente.
An diesem Tag schaltet OpenAI die Snapshots von GPT-4o und GPT-4.1 ab; darauf gebaute Werkzeuge ändern sich mit.
OpenAI-Abkündigungen, via Good AI Prism Registry
So setzen Sie die Seite ein
Drei Werkzeuge und ein Angebot machen aus dieser Seite eine Entscheidung.
- Karte Softwareentwicklung öffnen: 24 Angebote auf einem Blatt des Good AI Prisma, mit Logos und Anbieterfakten.
- Bis zu drei Angebote vergleichen: Entscheidungsfakten nebeneinander, jeweils mit Quelle und Datum.
- Rechner Task Economics starten: gesparte Stunden in zurechenbare Kapazität übersetzen, bevor ein Pilot freigegeben wird.
- Angebot: AI Decision Brief: zwei oder drei Coding-Werkzeuge Fakt für Fakt verglichen, mit Quellen, Daten und den Fragen vor der Unterschrift.
Zwölf Coding-Angebote, Fakt für Fakt
Abrechnungseinheit, Preis, Trainingsbedingungen, Datenstandort und Zertifikate, jeweils mit Quelle und Datum.
Grok Build (grok-code-fast-1)
xAI · Modell
xAIs grok-code-fast-1, inzwischen Alias für grok-build-0.1, ist ein schnelles Reasoning-Modell mit nativen Werkzeugaufrufen, entwickelt für mehrstufige agentische Coding-Schleifen innerhalb von Coding-Werkzeugen über eine OpenAI-kompatible API.
- Veröffentlichter Preis
- Kontextfenster (wie viel Text das Modell auf einmal verarbeitet)
- Modellzugang
- Betrieb: Cloud oder eigene Server
Morph Fast Apply
Morph · Modell
Modell, das die Dateischreibebene in KI-Programmieragenten und IDE-Plugins ersetzt; als MCP-Werkzeug für Claude Code, Cursor und ähnliche Umgebungen verfügbar.
- Veröffentlichter Preis
- Kontextfenster (wie viel Text das Modell auf einmal verarbeitet)
- Lizenz und Zugangsrechte
- Modellzugang
Mellum
JetBrains · Modellfamilie
Mehrsprachiges JetBrains-Modell mit 4B Parametern, von Grund auf zur Codevervollständigung trainiert, Grundlage cloudbasierter Vervollständigung in JetBrains IDEs.
- Veröffentlichter Preis
- Lizenz und Zugangsrechte
- Modellzugang
- Betrieb: Cloud oder eigene Server
voyage-code
Voyage AI (MongoDB) · Modellfamilie
Voyage AIs voyage-code-Familie (code-4 aktuell; code-3, code-2 älter) wandelt Quellcode in quantisierbare Embeddingvektoren mit Matryoshka-Größen um, damit Coding-Agenten und Codesuche relevante Dateien abrufen können.
- Veröffentlichter Preis
- Kontextfenster (wie viel Text das Modell auf einmal verarbeitet)
- Lizenz und Zugangsrechte
- Modellzugang
Auggie CLI
Augment Code · Agent
Terminalagent von Augment Code mit dessen Codebasiskontext-Engine für die Kommandozeile; interaktiv oder im --print-Modus für CI-Pipelines wie GitHub-Actions-PR-Prüfungen.
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Nutzt der Anbieter Ihre Daten zum Training?
- Zertifikate und Testate
CodeRabbit
CodeRabbit · Produkt
KI-Pull-Request-Prüfer für GitHub, GitLab, Bitbucket und Azure DevOps, der jeden PR automatisch prüft, eingehende PRs per Triage priorisiert und Sicherheitskorrekturen als PRs eröffnet.
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Nutzt der Anbieter Ihre Daten zum Training?
- Integrationen
Bolt
StackBlitz · Produkt
StackBlitz-Werkzeug vom Team hinter WebContainers zur Erstellung von Full-Stack-Webanwendungen mit zahlreichen JavaScript-Webframeworks.
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Nutzt der Anbieter Ihre Daten zum Training?
- Zertifikate und Testate
Tricentis Tosca AI agents
Tricentis · Produkt
Laut Tricentis: „Für die Tosca-Umgebung entwickelte KI-Agenten erzeugen aus natürlichsprachlichen Beschreibungen vollständige Ende-zu-Ende-Tests.“
- Wofür Sie bezahlen
- Datenstandort
- Nutzt der Anbieter Ihre Daten zum Training?
- Zertifikate und Testate
GitLab Duo Agent Platform
GitLab · Plattform
GitLabs Agentenschicht für GitLab.com, Self-Managed und Dedicated, in der Agenten und Flows Issues in Merge Requests umwandeln, Code prüfen und CI/CD-Pipelines reparieren, über GitLab Credits abgerechnet.
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Nutzt der Anbieter Ihre Daten zum Training?
- Zertifikate und Testate
Snyk DeepCode AI
Snyk · Produkt
Laut Snyk: „Der Codeanalysator DeepCode AI von Snyk wurde entwickelt, um Schwachstellen zu finden, automatisch zu beheben und zu priorisieren“
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Datenstandort
- Nutzt der Anbieter Ihre Daten zum Training?
SonarQube AI CodeFix
Sonar · Produkt
Laut Sonar: „AI CodeFix schlägt dann eine Änderung vor, die das Problem behebt, ohne die Funktionalität des Codes zu verändern.“
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Datenstandort
- Zertifikate und Testate
Zencoder
Zencoder · Plattform
Zencoder betreibt Multi-Modell-Coding-Agenten in VS Code und JetBrains IDEs sowie als CI-Worker ohne Oberfläche und indexiert mehrere Repositories, um Jira-, Linear- oder GitHub-Issues-Tickets in Änderungen über mehrere Dateien umzusetzen.
- Veröffentlichter Preis
- Wofür Sie bezahlen
- Nutzt der Anbieter Ihre Daten zum Training?
- Zertifikate und Testate
Vergleichsbasis: drei Einheiten, ein Team
Pro Platz, pro Credit und pro Monat mit Credits: alle drei in Kosten pro gemergter Änderung umrechnen.
| Angebot | Preis | Abrechnung | Training | Quelle |
|---|---|---|---|---|
| CodeRabbit | $24–72 /user/mo | Pro Nutzer und Monat | Kein Training | CodeRabbit, Preisseite |
| GitLab Duo Agent Platform | $1 per credit | GitLab Credits (Nutzung) | Kein Training | GitLab Duo, Preisseite |
| Snyk DeepCode AI | Free · from $25 /mo | Monatlich · Credits (Ent.) | Kein Training | Snyk DeepCode AI, Dokumentation |
Registerfakten, wie sie die Anbieter auf ihren eigenen Seiten nennen, gelesen am 21. Okt. 2026. Ergänzen Sie im Vergleich Ihre eigenen Mengen, bevor Sie entscheiden.
Regeln und Termine
Modellabschaltungen und Preisänderungen erreichen Ihre Werkzeuge zuerst.
- 2. Aug. 2025
Pflichten für KI-Modelle mit allgemeinem Verwendungszweck gelten.
VO (EU) 2024/1689
- 2. Aug. 2026
Art. 50: Menschen müssen erfahren, dass sie mit einem KI-System interagieren.
VO (EU) 2026/1744
- 30. Nov. 2026
Anthropic schaltet den Modell-Snapshot claude-sonnet-4-5-20250929 ab.
Anthropic, Modellabkündigungen
- 1. Dez. 2026
Der Listenpreis von Gemini 4 Argon verdoppelt sich auf 4 / 20 US-$ je Million Tokens.
Google, Gemini-API-Preise
- 14. Jan. 2027
OpenAI schaltet die Snapshots von GPT-4o und GPT-4.1 ab; darauf gebaute Werkzeuge ändern sich.
OpenAI, Abkündigungen
Die Belege lesen
Globale Ausgabe · DE
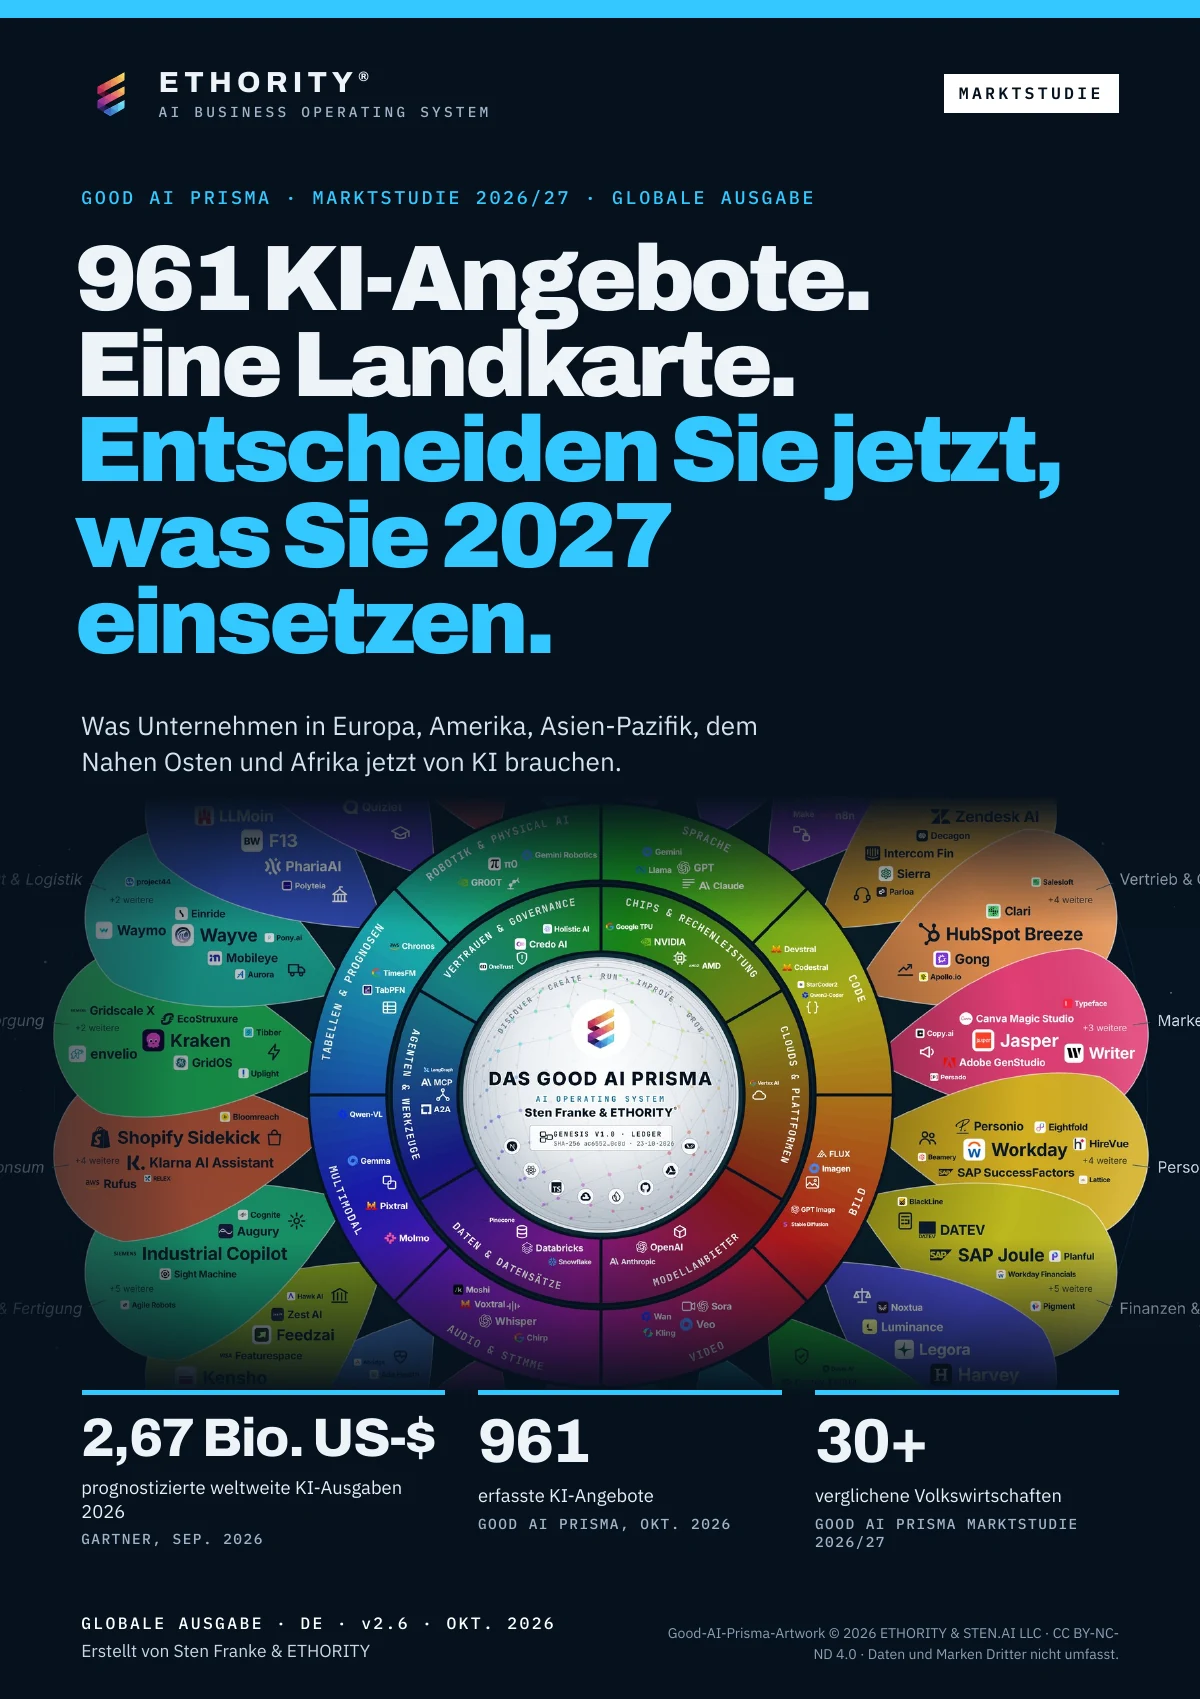
961 KI-Angebote. Eine Landkarte. Entscheiden Sie jetzt, was Sie 2027 einsetzen.
Das Good AI Prisma hilft Ihnen, sinnvolle KI-Anwendungen zu finden und die Belege zu Ihren Optionen zu vergleichen. Für Unternehmen, die KI schon nutzen, verschiebt sich die Frage von „ob KI“ zu „welche KI, wie sicher und ob sie sich rechnet“. Diese globale Ausgabe umfasst 961 KI-Angebote in 24 Themenfeldern, 8 Datenarten und 6 Technologieschichten – mit Quellen, Datenstand und Grenzen der Aussagekraft, damit Sie Ihre nächste Entscheidung fundiert treffen.
Version 2.6 · 90 Seiten
Studie lesen →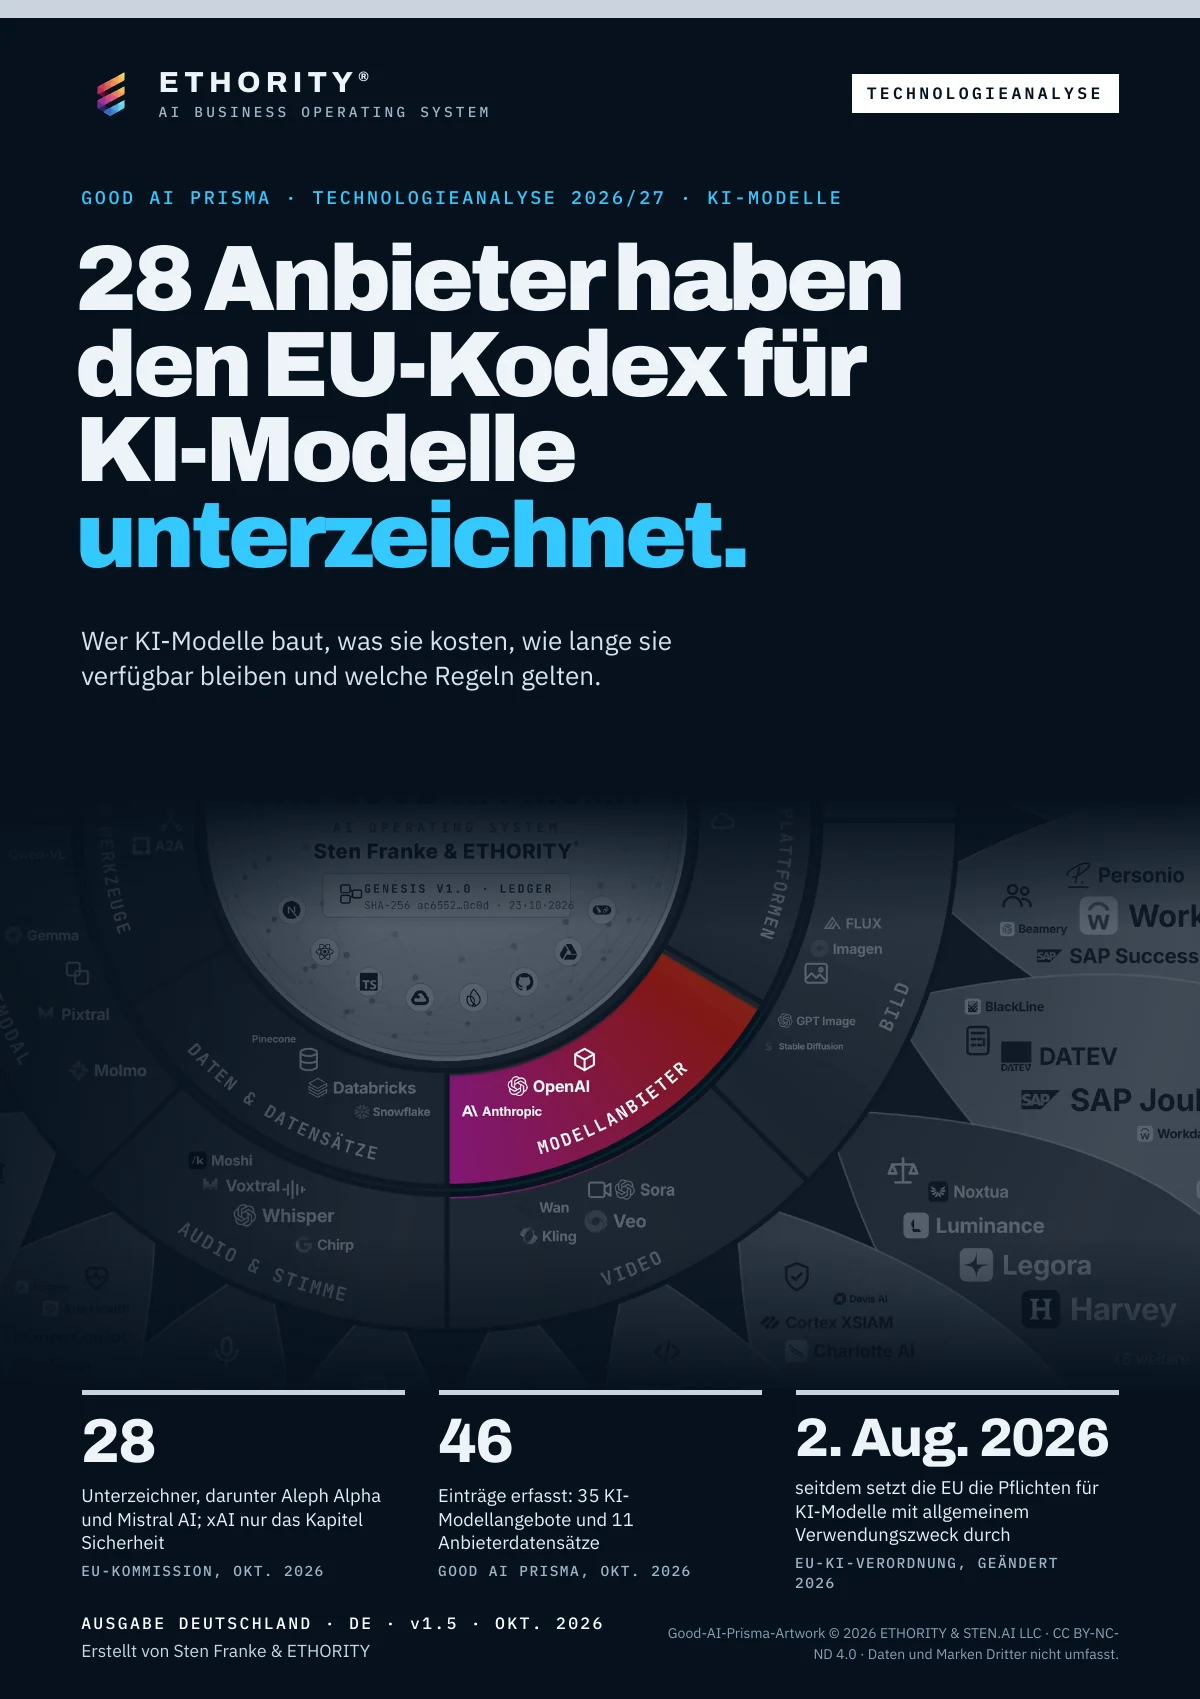
Deutschland · DE
28 Anbieter haben den EU-Kodex für KI-Modelle unterzeichnet.
KI-Modelle als Portfolio steuern: wer sie baut, was sie kosten, wie lange sie verfügbar bleiben und welche Regeln gelten.
Version 1.5 · 38 Seiten
Studie lesen →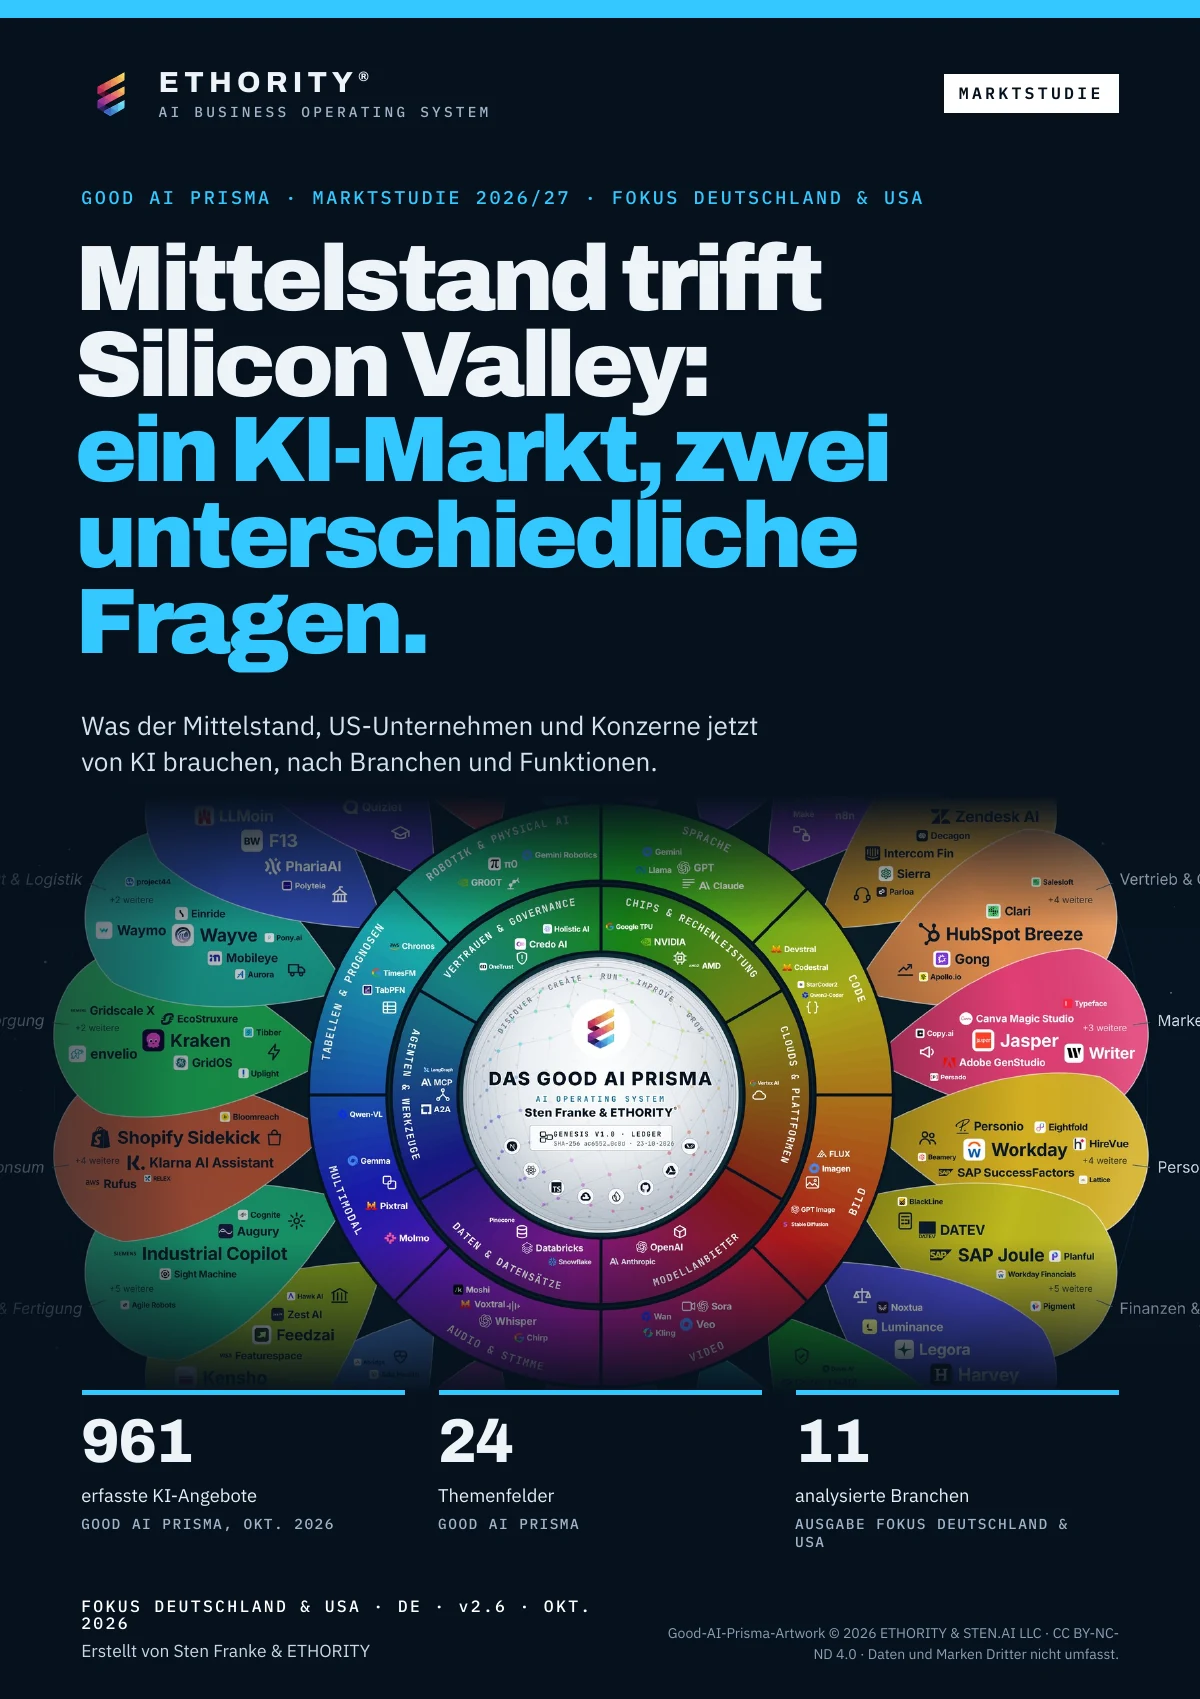
Fokus Deutschland & USA · DE
Mittelstand trifft Silicon Valley
Der Mittelstand braucht Know-how, US-Firmen brauchen Kostenkontrolle. Was deutsche und US-Unternehmen jetzt von KI brauchen, nach Branchen und Funktionen.
Version 2.6 · 72 Seiten
Studie lesen →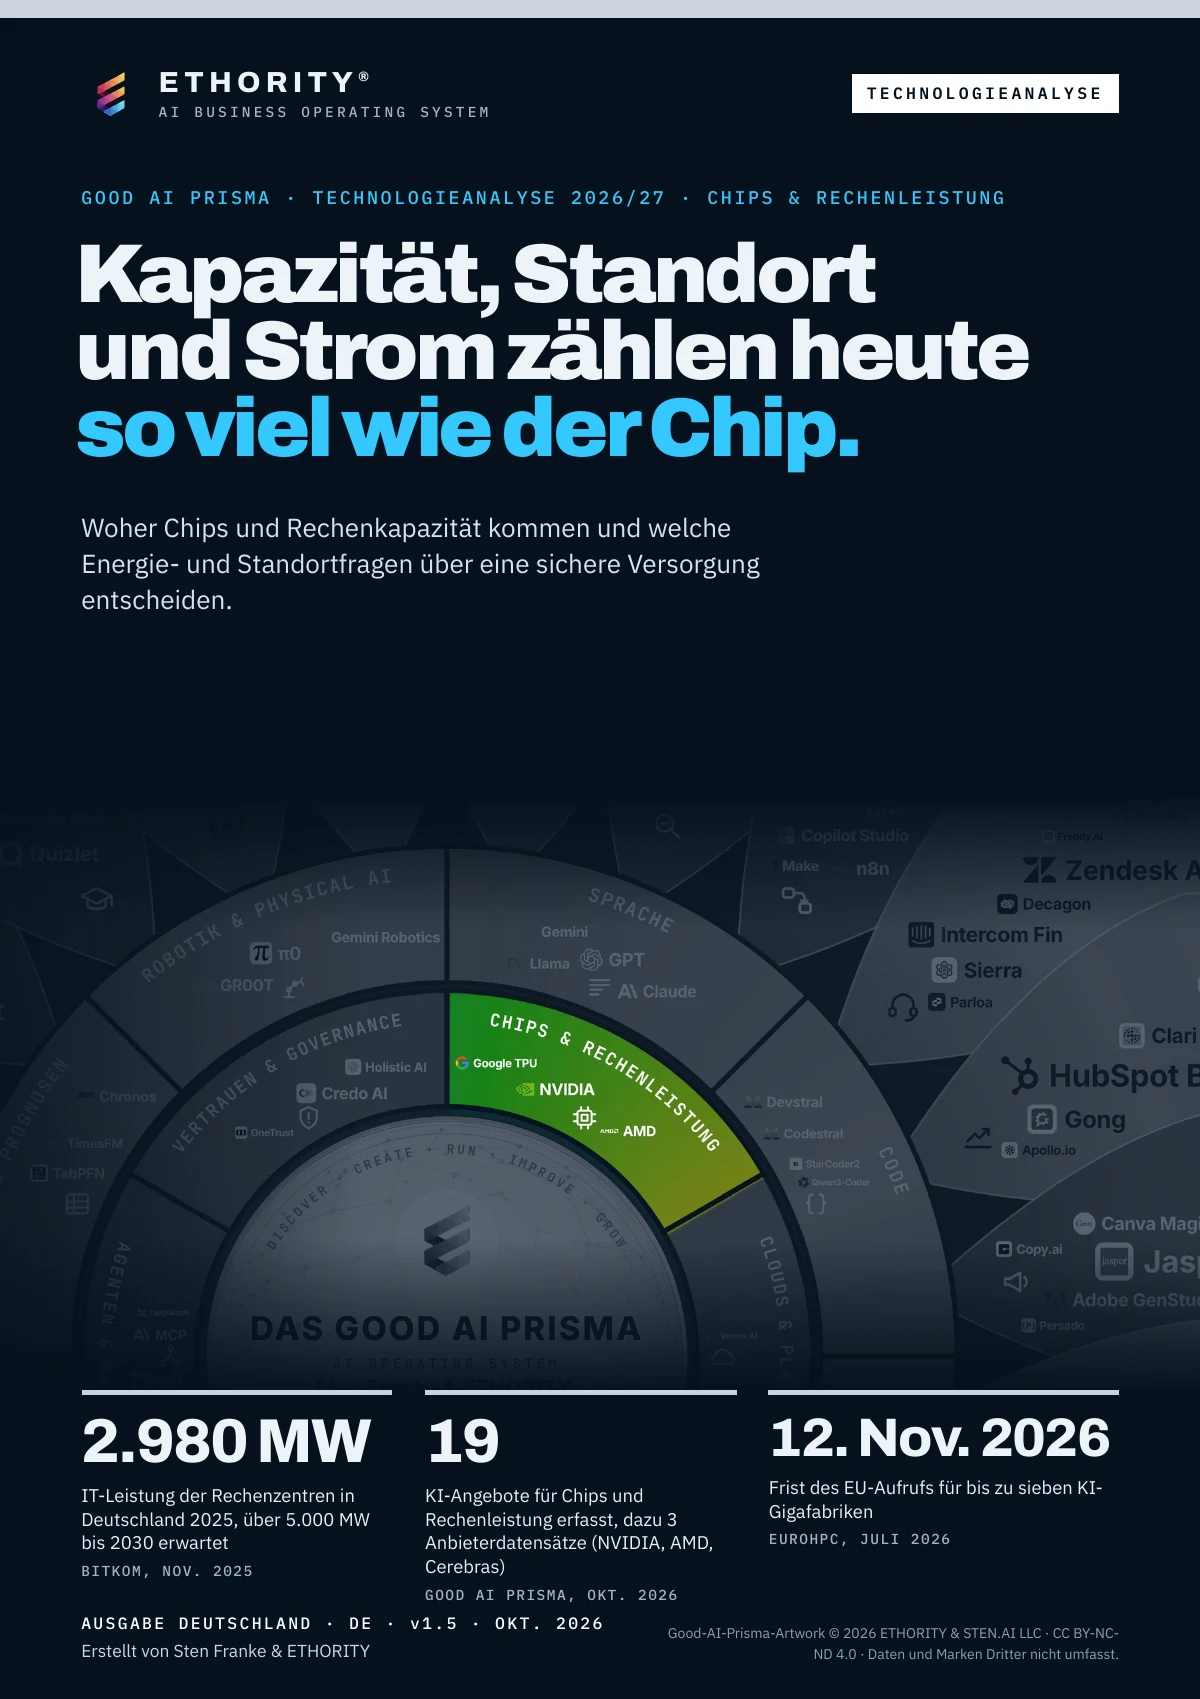
Deutschland · DE
Rechenleistung, die zu Ihrer Aufgabe passt.
Kapazität, Region und Energiebedingungen zählen heute so viel wie die Leistung des Chips. Woher Chips und Rechenkapazität kommen und was eine sichere Versorgung entscheidet.
Version 1.5 · 38 Seiten
Studie lesen →Verwandte Analysen
961 KI-Angebote: Beginnen Sie bei der Aufgabe, nicht beim Werkzeug.
KI wirksam einsetzen mit Methode statt Liste: vom konkreten Bedarf zur belastbaren Auswahlliste im KI-Markt.
Analyse zur Karte lesen →
Gesparte Stunden sind noch kein KI-Wert.
Trennen Sie, was die KI an einer Aufgabe verbessert, welche Zeit sie freisetzt und was das Geschäft davon hat.
Analyse zur Karte lesen →
Eine Anbieterzusage ist noch kein Beleg.
Prüfen Sie jede Zusage eines Anbieters an Produkt, Version, Vertrag und Einsatzzweck, bevor Sie sich darauf verlassen.
Analyse zur Karte lesen →
KI wächst nicht von selbst mit – die Arbeit muss sich ändern.
Beginnen Sie mit einem Ziel, wählen Sie je Aufgabe den einfachsten Weg und messen Sie die Kosten je abgenommenem Ergebnis.
Analyse zur Karte lesen →Mit ETHORITY umsetzen
AI Decision Brief
195 € netto · einmalig
Stellt die entscheidenden Fakten zu zwei oder drei KI-Angeboten nebeneinander, jeweils mit Quelle und Datum, plus die Fragen an jeden Anbieter.
Umfang und Lieferung anfragen
Leistungsumfang des Pakets ansehen →AI Opportunity Case
Preis nach Umfang
Vergleicht echte Optionen einschließlich Nichtstun, rechnet die Wirtschaftlichkeit samt kritischer Annahmen durch und empfiehlt: starten, ändern, erst testen oder stoppen.
Umfang und Lieferung nach Vereinbarung
Leistungsumfang des Pakets ansehen →AI Literacy & Adoption
2.400 € einmalig · netto
Baut KI-Kompetenz und gelebte Nutzung in Ihren Teams auf, abgestimmt auf die KI-Kompetenzpflicht des EU AI Act.
Umfang und Lieferung nach Vereinbarung
Leistungsumfang des Pakets ansehen →Fragen von Einkäufern
Machen KI-Coding-Werkzeuge Entwickler schneller?
Manchmal. Kontrollierte Studien reichen von 19 % langsamer (METR-Studie, Juli 2025) bis rund 21 % schneller (Google-RCT). Messen Sie Durchlaufzeit und Fehlerquote Ihres eigenen Teams vorher und nachher.
Wird unser Code zum Training der Anbietermodelle genutzt?
Das hängt vom Tarif ab. Sechs der 12 profilierten Angebote erklären, Kundencode nicht fürs Training zu nutzen; eines erlaubt Training mit Daten aus Gratiskonten. Lesen Sie die Bedingungen Ihres Tarifs, wie die Registerkarte von Zencoder zeigt.
Wie vergleichen wir Preise in Tokens, Credits und Lizenzen?
Rechnen Sie jede Option bei Ihrem Volumen in Kosten pro übernommener Änderung um, inklusive Review-Zeit. Der Einkaufsleitfaden zu 961 Angeboten beschreibt die Methode.
Welche Werkzeuge halten Daten in der EU?
Drei der 12 profilierten Karten nennen eine EU-Region oder EU als Standard: Snyk, SonarQube und Tricentis. Die Karte von SonarQube AI CodeFix nennt Frankfurt als Standard.
Was passiert, wenn das Modell unter einem Werkzeug abgeschaltet wird?
Verhalten, Preis oder Qualität können sich ändern. Halten Sie Modell und Abschalttermin je Werkzeug fest; die Technologieanalyse KI-Modelle nennt die aktuellen Termine.
Die Nachweise auf einen Blick
ETHORITY · ANALYSE
Coding-KI: 19 % langsamer bis 21 % schneller. Messen Sie selbst.
84 % der Entwickler nutzen KI, 46 % misstrauen ihr. Kontrollierte Studien sind sich beim Nutzen uneins. Das Good AI Prisma zeigt, was sich stattdessen vergleichen lässt: Abrechnung, Training, Datenstandort und die Modelle darunter.
In der Softwareentwicklung ist KI längst Alltag. Vertrauen hat sie sich dort noch nicht erarbeitet. In der Stack-Overflow-Umfrage 2025 gaben 84 % der Entwicklerinnen und Entwickler an, KI-Werkzeuge zu nutzen oder ihren Einsatz zu planen. Zugleich misstrauen 46 % aktiv der Genauigkeit dieser Werkzeuge, nur 33 % vertrauen ihr. Zwei Drittel, 66 %, nennen als größtes Ärgernis Lösungen, die „fast richtig, aber eben nicht ganz“ sind.
Diese Lücke zwischen Nutzung und Vertrauen ist der Marktbefund 2026 für die Softwareentwicklung. Sie entscheidet, was Einkäufer verlangen sollten, was Teams messen müssen und welche Angebote auf die Shortlist gehören.
Gemessene Effekte zeigen in beide Richtungen
Die belastbarsten Daten zu Coding-KI stammen aus kontrollierten Studien – und die widersprechen sich. In einer randomisierten Studie von METR vom Juli 2025 bearbeiteten 16 erfahrene Open-Source-Entwickler 246 echte Aufgaben in ihren eigenen Repositories. Mit KI-Werkzeugen brauchten sie 19 % länger. Vorher hatten sie mit 24 % Zeitgewinn gerechnet. Hinterher glaubten sie noch immer, 20 % schneller gewesen zu sein.
Eine randomisierte Studie bei Google kam zum umgekehrten Ergebnis: Mit KI-Funktionen lösten Ingenieure eine Unternehmensaufgabe rund 21 % schneller. Die Globale Marktstudie 2026/27 stellt beide Befunde bewusst nebeneinander. Beide stimmen. Sie messen unterschiedliche Arbeit, unterschiedliche Entwickler und unterschiedliche Werkzeuge.
−19 % bis +21 %. So weit reicht die gemessene Spanne der KI-Effekte in der Softwarearbeit. Wo Ihr Team liegt, zeigt nur Ihre eigene Ausgangsmessung.
Für Einkäufer folgt daraus eine nüchterne Regel: Die Produktivitätszahl eines Anbieters ist nicht Ihre Ausgangsbasis. Der Effekt hängt von Codebasis, Aufgabentyp und Erfahrung ab. Wer Durchlaufzeit und Fehlerquote bei Änderungen vor und nach der Einführung misst, weiß, wo er steht. Wer sich auf das Gefühl verlässt, kann gründlich danebenliegen: In der METR-Studie lagen gefühlte und gemessene Geschwindigkeit 39 Punkte auseinander.
Wohin Budgets und Agenten fließen
Die Softwareentwicklung gehört zu den Feldern, in denen Unternehmen Erträge melden. Im McKinsey State of AI 2025 nannten die Befragten Kostenvorteile am häufigsten in Softwareentwicklung, Fertigung und IT. Die Ausgabe vom August 2026 ergänzt: KI-Agenten skalieren Unternehmen am häufigsten in IT, Wissensmanagement und Softwareentwicklung.
Das Geld folgt. Gartners Prognose der KI-Ausgaben vom September 2026 beziffert KI-Plattformen für die Anwendungsentwicklung auf 9,5 Mrd. US-$ im Jahr 2026, nach 6,9 Mrd. US-$ im Vorjahr; generative KI-Modelle auf 28,3 Mrd. US-$. Coding-Werkzeuge laufen auf diesen Modellen. Die Modellebene ist deshalb Teil jeder Coding-Entscheidung. Die Technologieanalyse KI-Modelle zeigt, warum: 81 % der Großunternehmen setzen bereits drei oder mehr Modellfamilien ein (a16z, Jan. 2026).
Was das Prisma über Coding-Angebote zeigt
Das Good AI Prisma ordnet der Softwareentwicklung 24 KI-Angebote zu – von Code-Vervollständigung und Review über Testagenten bis zu code-spezifischen Embeddings. Zwölf davon haben eine vollständige Registerkarte mit belegten Entscheidungsfakten, gelesen auf den Anbieterseiten am 20. Okt. 2026.
Übersicht: zwölf profilierte Coding-Angebote nach den Fakten, die Einkäufer brauchen
| Entscheidungsfakt | Was die 12 Karten zeigen |
|---|---|
| Abrechnungseinheit | Mindestens fünf Einheiten: Tokens, Credits, Plätze, Tarifstufen, nur Rechenleistung |
| Training mit Ihrem Code | 6 erklären, Kundencode nicht fürs Training zu nutzen; andere bieten Opt-in oder Opt-out |
| Datenstandort EU | 3 nennen eine EU-Region oder EU als Standard (Snyk, SonarQube, Tricentis) |
| Selbst betreiben | 6 bieten Self-Hosting, Self-Managed, On-Prem oder offene Gewichte |
| Veröffentlichter Preis | 11 nennen einen Listenpreis |
Quelle: Good AI Prism Registry, Anbieterseiten gelesen am 20. Okt. 2026.
Drei Muster fallen auf. Erstens: Preise kommen in Einheiten, die sich nicht direkt vergleichen lassen. Die Registerkarte von CodeRabbit nennt 24–72 US-$ pro Nutzer und Monat. GitLab Duo rechnet 1 US-$ pro Credit ab. Das Coding-Modell von Grok kostet 1 US-$ pro Million Eingabe-Tokens und 2 US-$ pro Million Ausgabe-Tokens. Ein Team mit 40 Entwicklern muss alle drei in Kosten pro übernommener Änderung umrechnen, bevor der Vergleich etwas aussagt.
Zweitens: Die Trainingsbedingungen unterscheiden sich sogar innerhalb eines Produkts. Ein profilierter Assistent regelt in seinen Nutzungsbedingungen, dass Daten aus Test- und Bezahlkonten nur mit gesonderter Zustimmung ins Training gehen, Daten aus kostenlosen Konten dagegen genutzt werden dürfen. Ein Pilot im Gratistarif kann also anderen Regeln folgen als der Vertrag, den Sie später unterschreiben.
Drittens: Der Datenstandort steht selten in der Überschrift. Nur drei der zwölf Karten nennen eine EU-Region oder EU als Standard. SonarQube AI CodeFix gibt Frankfurt als EU-Standard an. Für ein europäisches Unternehmen mit vertraglich geschütztem Kundencode kann genau dieser eine Fakt die Shortlist entscheiden.
Szenario. Ein Team mit 40 Entwicklern zahlt bei CodeRabbit zu 24–72 US-$ pro Nutzer 960–2.880 US-$ im Monat. Bei 1.200 gemergten Änderungen im Monat sind das 0,80–2,40 US-$ pro Änderung, ohne Prüfzeit. Rechnen Sie dasselbe für Credits und Tokens, dann vergleichen Sie.
Modelle gehen in Rente – und Ihre Werkzeuge mit
Coding-Werkzeuge erben den Lebenszyklus der Modelle darunter. Das Register verzeichnet, dass OpenAI seine Snapshots von GPT-4o und GPT-4.1 am 14. Jan. 2027 abschaltet. Anthropic listet Claude Opus 5.5 mit 4 US-$ pro Million Eingabe- und 20 US-$ pro Million Ausgabe-Tokens, Abschaltung nicht vor dem 22. Sep. 2027. Ein Assistent, der an einem älteren Modell hängt, kann Verhalten, Preis oder Qualität ändern, sobald sein Anbieter wechselt.
Fragen Sie jeden Anbieter, von welchem Modell und welcher Cloud sein Produkt abhängt und wie er Wechsel ankündigt. Der Einkaufsleitfaden zu 961 Angeboten behandelt das als Standardfrage für jede Shortlist. In der Softwareentwicklung zählt sie doppelt: Ein Modellwechsel kann den Code verändern, den Ihr Team ausliefert.
46 % der Entwickler misstrauen aktiv der Genauigkeit von KI-Werkzeugen, während 84 % sie nutzen oder planen (Stack Overflow, 2025).
Die Abrechnung wandert zur Nutzung
Platzlizenzen weichen Credits, Tokens und Aktionen. Gartner erwartet laut Deloitte, zitiert in der Globalen Marktstudie, dass bis 2030 mindestens 40 % der SaaS-Ausgaben nutzungs-, agenten- oder ergebnisbasiert abgerechnet werden. Für Engineering-Verantwortliche lautet die Budgetfrage dann nicht mehr „Wie viele Lizenzen?“, sondern „Wie viele übernommene Änderungen zu welchen Kosten?“. Nutzungspreise belohnen Teams, die ihr Volumen kennen. Wer es erst auf der Rechnung entdeckt, zahlt drauf.
Auch die Wertfrage verschiebt sich. Gesparte Minuten in der Entwicklungsumgebung sind noch kein Geschäftswert. Wie die ETHORITY-Evidenzsynthese Gesparte Stunden sind noch kein KI-Wert zeigt, entsteht Wert erst, wenn die frei gewordene Kapazität in Arbeit fließt, die ein zurechenbares Ergebnis verändert.
Was Sie am Montag tun
- Zwei Kennzahlen messen, bevor Sie ein Werkzeug wählen. Erfassen Sie für ein Team vier Wochen lang Durchlaufzeit und Fehlerquote bei Änderungen. Ohne diese Basis lässt sich kein Anbieterversprechen prüfen.
- Drei Werkzeuge nach Kosten pro übernommener Änderung vergleichen. Rechnen Sie Lizenzen, Credits und Tokens bei Ihrem Volumen in eine Einheit um. Planen Sie Review-Zeit für KI-Code ein – der 66-%-Befund zum „fast richtig“ sagt, dass sie nicht null sein wird.
- Trainings- und Datenbedingungen des Tarifs lesen, den Sie wirklich kaufen. Gratis- und Testtarife können anders geregelt sein. Lassen Sie sich die EU-Region schriftlich bestätigen, wenn Kundencode im Spiel ist.
- Das Modell unter jedem Werkzeug benennen. Halten Sie Modell, Anbieter und angekündigtes Abschaltdatum fest und setzen Sie eine Überprüfung bei jedem Modellwechsel.
- Eine Abbruchbedingung festlegen. Vereinbaren Sie vorab, welches Ergebnis den Pilot beendet. Verbessern sich Durchlaufzeit und Fehlerquote bei Ihrem Volumen nicht, stoppen Sie und sichern Sie die Belege.
Das Good AI Prisma hält die Registerkarten für dieses Themenfeld aktuell, jeder Entscheidungsfakt mit Quelle und Datum. Für einen schriftlichen Vergleich von zwei oder drei Coding-Angeboten stellt das Angebot AI Decision Brief die entscheidenden Fakten nebeneinander.
Quellen und weiterführende Literatur
- Stack Overflow Developer Survey 2025: AI ↗ · Jul 2025
- METR: Measuring the impact of early-2025 AI on experienced open-source developer productivity ↗ · 10 Jul 2025
- Google: How much does AI impact development speed? An enterprise-based randomized controlled trial (arXiv 2410.12944) ↗ · 2024–2025
- McKinsey: The state of AI in 2025 (1,993 respondents, 105 countries) ↗ · 5 Nov 2025
- McKinsey: The state of AI, August 2026 edition (1,719 respondents, 97 countries) ↗ · 25 Aug 2026
- Gartner: Worldwide AI spending to grow 49.5% in 2026 ↗ · 16 Sep 2026
- a16z: enterprise AI survey (via Good AI Prism AI Models brief) ↗ · Jan 2026
- Good AI Prism Global Market Study 2026/27 (ETHORITY) → · 22 Oct 2026
- Good AI Prism Registry cards, provider pages read 20 Oct 2026 (ETHORITY) → · 20 Oct 2026
- OpenAI: API deprecations (GPT-4o and GPT-4.1 snapshots) ↗ · read 25 Oct 2026
Die Gedanken praktisch nutzen
AI Opportunity Case →
Eine begründbare Entscheidung für Umsetzung, Test, Neugestaltung, Aufschub oder Stopp. Das Honorar ist unabhängig vom evidenzgestützten Ergebnis.
AI Decision Brief – Entscheidungsvorlage für bis zu drei KI-Angebote · 195 € netto →
Beginnen Sie mit einer Frage und bis zu drei Angeboten. Fragen Sie einen belegten Vergleich, Anbieterfragen und eine Kostenskizze mit Ihren Annahmen an.
VON DEN BELEGEN ZU IHRER ENTSCHEIDUNG
Besprechen Sie Ihre Frage mit Sten Franke.
Bringen Sie Ihre Geschäftsfrage oder die bereits bekannten Zahlen mit. ETHORITY recherchiert im vereinbarten Umfang; gemeinsam mit Sten Franke legen Sie den sinnvollen nächsten Arbeitsschritt fest.